

В статье мы расскажем все об индексации страниц сайта в поисковых системах, опишем, что это такое и как происходит процесс. Без успешного сканирования ресурс не попадет в выдачу и не займет выгодные позиции в топе, которые влияют на получение органического трафика. Проблемы с индексом могут возникнуть из-за наличия технических ошибок, а также из-за размещения некачественного контента в разделах. Поэтому прежде чем приступать к продвижению площадки, стоит провести тщательный техаудит и сделать анализ контентных блоков.
- Что такое индексирование
- Как происходит включение в индекс
- Как проходит обход
- Индексация в Google и Яндексе — в чем разница
- Краулинговый бюджет: что это и как оптимизировать
- Сколько времени занимает индексация
- Ускорить индексацию страниц сайта: что это значит
- Как управлять индексацией в поисковиках
- Как проверить, присутствует ли площадка в поиске
- Сайт не индексируется: что это означает
- Индексация AI-контента
- Коды ответа сервера и индексация
- Список действий, если страница не индексируется
- Заключение
Что такое индексирование
Это размещение информации о веб-сайте в базе данных поисковых систем. Благодаря этому ресурс становится доступным для пользователей в выдаче. Только после индексации веб-площадка начинает участвовать в ранжировании и конкурировать за хорошее место в топе поисковиков. Если у нее есть проблемы в сканировании, и роботы ее не обходят, тогда SEO-продвижение будет бессмысленным. Для начала необходимо исправить все ошибки, а затем приступать к раскрутке.
За обход веб-страниц отвечают боты, то есть краулеры. Это специальные алгоритмы, которые ходят по площадкам и проверяют их, а затем обрабатывают информацию.
- текстовый блок;
- изображения;
- видео;
- мета-теги;
- ссылки;
- таблицы;
- различные формы заявок, кнопки.

Если при обходе роботы не обнаружили проблем, страничка проиндексируется – это значит, что ее увидят пользователи в поисковой выдаче. Даже при обнаружении ошибки ресурс может попасть в базу данных, однако в поиске он будет отсутствовать до тех пор, пока все найденные недочеты не будут устранены.
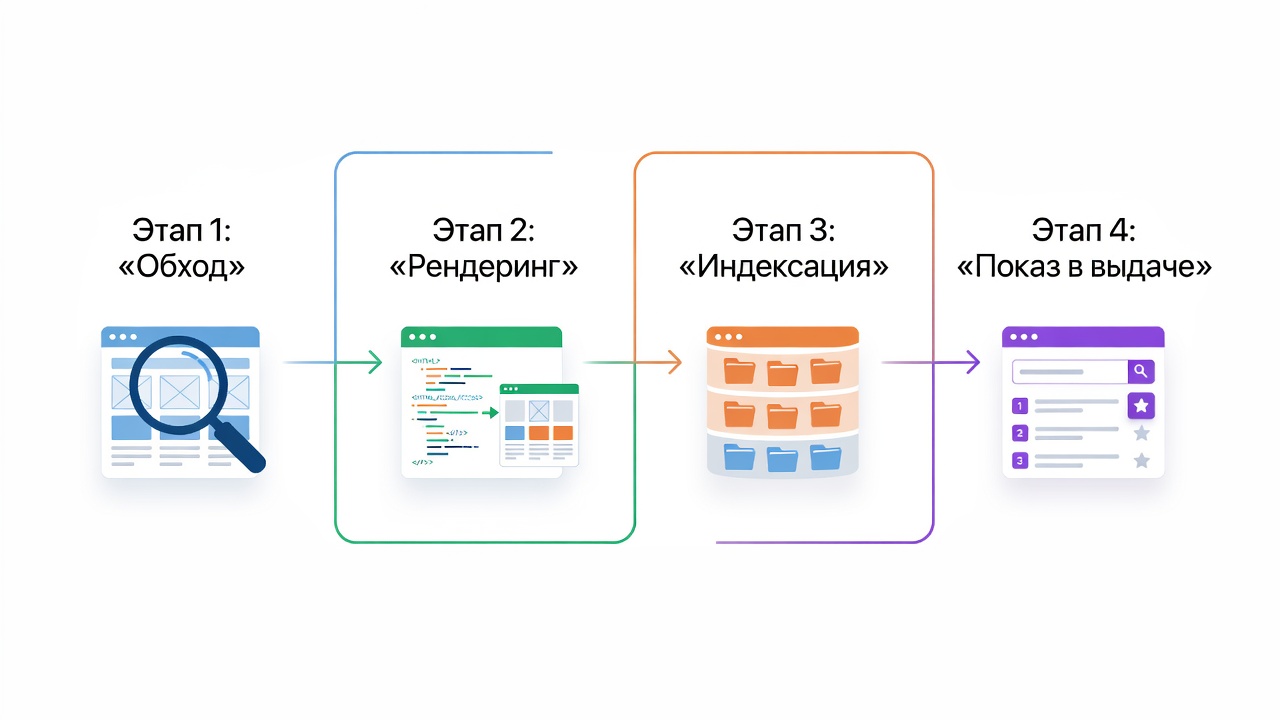
Как происходит включение в индекс
Индексация — это не единое действие, а цепочка из четырех последовательных этапов. Понимание каждого поможет диагностировать проблемы и правильно оптимизировать сайт.
Этап 1. Crawling — обход сайта роботами
Поисковый бот (краулер) находит страницу через ссылки из уже известных ему источников, sitemap.xml, IndexNow-уведомления или прямое добавление в вебмастере. Прежде чем начать обход, робот проверяет файл robots.txt на предмет разрешённых и запрещённых для сканирования разделов. Основные краулеры — Googlebot и YandexBot.
Этап 2. Rendering — рендеринг страницы
Робот запрашивает содержимое, обрабатывает HTML, CSS и JavaScript, «собирает» финальную версию веб-страницы так, как её видит пользователь. Это критически важно для современных сайтов на React, Vue, Angular — если JavaScript не отрендерится, робот не увидит контент.
Google использует полноценный движок рендеринга на базе Chromium, Яндекс менее эффективно работает с JS — для JavaScript-сайтов рекомендуется server-side rendering (SSR).
Этап 3. Indexing — добавление в индекс
После рендеринга робот анализирует содержимое: уникальность текста, релевантность запросам, качество изображений, корректность мета-тегов, наличие дублей. Если страница проходит проверку, она добавляется в базу данных поисковика — индекс.
На этом этапе действуют алгоритмы качества: Google Helpful Content, Panda, Яндекс «Проксима», «Y1». Если контент признан низкокачественным, страница может быть исключена из индекса.
Этап 4. Serving — показ в выдаче
Проиндексированная страница участвует в ранжировании — конкурирует с другими страницами за позиции в выдаче по конкретным запросам. Здесь работают факторы ранжирования: поведенческие, ссылочные, коммерческие, технические.
Важно понимать: индексация ≠ высокие позиции. Страница может быть в индексе, но не показываться пользователям из-за низкой релевантности или слабых поведенческих факторов.
Как проходит обход
Специальные роботы переходят на продвигаемую площадку, и первым делом они обращаются к файлу robots.txt. Там расположены разрешающие и запрещающие директивы, которые значат, что какие-то страницы должны индексироваться, а другие нет. Помимо этого, в данном файле можно прописать правило, которое совсем закроет контент от индекса. Если такого запрета нет, то боты приступят к сканированию.
Они переходят по каждой ссылке, анализируют контент, оценивает тексты, изображения, видео, мета-теги, корректность url, техническую оптимизацию. Затем у текстовых блоков проверяются: уникальность, наличие переспама, содержание, релевантность продвигаемым запросам.
Если после обхода краулеры не обнаружили каких-либо проблем на платформе, через время она появится в выдаче и будет готова к SEO-продвижению.
На каждый ресурс поисковые системы выделяют краулинговый бюджет – это число урлов, которое боты смогут обойти в рамках одного посещения.
Индексация в Google и Яндексе — в чем разница
Точные алгоритмы индексирования неизвестны никому, так как эта информация является коммерческой, ее строго охраняют и не раскрывают. Однако обе поисковые системы используют и robots.txt, и sitemap.xml, но по-разному приоритизируют источники информации о структуре сайта.
С 2024 года Гугл полностью завершил переход на mobile-first indexing — теперь поисковик сканирует и индексирует исключительно мобильную версию сайта. Если она неполная или отличается от десктопной по контенту, часть информации может не попасть в индекс. Требования к мобильной версии: адаптивность, соответствие контенту десктопа, приемлемая скорость загрузки.
Согласно официальной документации Гугл, бюджет зависит от:
- Скорости работы сервера (медленные получают меньший бюджет).
- Популярности страниц (востребованные ресурсы обходятся чаще).
- Технического состояния сайта (много ошибок = меньший бюджет).
- Возраста и авторитетности домена.роботы.
Яндекс
В отличие от Google, здесь предпочтение отдают десктопной версии. Боты Яндекса анализируют ее корректность, качество и наполненность полезным контентом. Мобильная версия тоже важна, но воспринимается как дополнение.
Внимание: Яндекс.Турбо-страницы закрыты в 2024 году. Вместо них рекомендуется использовать классическую адаптивную мобильную версию с хорошей оптимизацией скорости.
Яндекс быстрее проиндексирует контент у той площадки, у которой наиболее высокая посещаемость. То есть если большое количество пользователей переходят на сайт, значит, он полезен и удобен для них. Следовательно, этот ресурс качественный и его следует придержать в топе.
С 2023 года Яндекс активно использует данные Яндекс.Метрики для обхода — если на сайте установлен счетчик, робот может узнавать о новых страницах через посещения пользователей.
Сравнительная таблица.
| Параметр | Яндекс | |
| Приоритет версии | Mobile-first (полностью с 2024) | Desktop, но учитывает мобильную |
| JavaScript-рендеринг | Отличный (движок Chromium) | Хуже, требует SSR |
| Средний срок индексации новых страниц | От нескольких часов до 2–4 недель | От нескольких дней до 2–3 недель |
| Поддержка IndexNow | Нет (официально) | Да, полная поддержка |
| Инструмент вебмастера | Google Search Console | Яндекс.Вебмастер |
| Быстрый переобход | URL Inspection (1 URL за раз) | Переобход страниц (списком) |
| Дополнительные источники | Sitemap, ссылки, ручное добавление | Sitemap, robots.txt, счетчики Метрики |
| Отношение к дублям | Каноникализация, ошибок мало | Строже, чаще исключает дубли |
Краулинговый бюджет: что это и как оптимизировать
Это количество страниц, которые робот готов обойти на вашем сайте за определенный промежуток времени. Для небольших сайтов (до 10 000 страниц) это редко становится проблемой. Но для крупных проектов (интернет-магазины, порталы, СМИ) оптимизация краулингового бюджета критически важна.
- Google Search Console → отчёт «Статистика сканирования».
- Яндекс.Вебмастер → «Индексирование» → «Статистика обхода».
- Анализ логов сервера через инструменты вроде Screaming Frog Log File Analyser.
- Удалить или закрыть от индексации мусорные страницы (фильтры, пагинация, дубли).
- Настроить корректные редиректы (избегать длинных цепочек).
- Убрать битые ссылки (404, 500 ошибки).
- Улучшить скорость сервера — быстрые ответы позволяют боту обойти больше страниц.
- Правильная структура sitemap.xml с указанием приоритетов и дат обновления.
- Внутренняя перелинковка — важные страницы должны быть в 2–3 кликах от главной.
Сколько времени занимает индексация
Сроки сильно зависят от типа сайта, его авторитетности и настроек:
| Тип сайта | Яндекс | |
| Новый | 1–4 недели | 2–4 недели |
| Молодой (< 1 года) | 2–7 дней | 3–10 дней |
| Устоявшийся | От нескольких часов до 2–3 дней | 1–5 дней |
| Крупный авторитетный (СМИ, маркетплейсы) | Минуты — часы | Часы — 1 день |
| Страница, добавленная через IndexNow | — | 1–15 минут |
| Страница, отправленная через URL Inspection в GSC | От нескольких часов до 1–2 дней | — |
Важно: Google в 2024–2026 году заметно замедлил индексирование новых сайтов и страниц с некачественным контентом. Приоритет отдаётся авторитетным ресурсам и уникальному, полезному контенту.
Ускорить индексацию страниц сайта: что это значит
- sitemap.xml;
- Яндекс.Вебмастер;
- Google Search Console.
- IndexNow (для Яндекса и Bing).
- Внутренняя перелинковка.
- Внешние ссылки и упоминания на других сайтах.
Разберем подробнее каждый метод.
Sitemap
С помощью различных плагинов автоматически генерируется карта, куда входят ссылки на все полезные урлы. К этому файлу обращаются боты, чтобы понять, какие страницы нужно проиндексировать в первую очередь при обходе. Поэтому важно в setmap.xml указывать приоритетность страничек и даты обновления контента.
Наличие карты позволяет краулерам лучше ориентироваться в структуре ресурса, что не только улучшает, но и ускоряет индексирование.
Яндекс.Вебмастер
Сервис имеет инструмент, который позволяет отправить странички на переобход. Для каждой площадки есть ограничение по добавлению url для обхода. Вероятно, число ссылок зависит от краулингового бюджета сайта. Чтобы воспользоваться данным инструментом, необходимо зайти в Яндекс.Вебмастер в разделы:
Индексирование => Переобход страниц

Далее добавляете список url в специальное окно и кликаете на кнопку «Отправить», через некоторое время отобразится статус обхода.
 Читайте также
Коммерческие факторы ранжирования: что это в SEO и какими они бывают
Google Search Console
Аналогичный инструмент есть и в Вебмастере Google. Однако сразу добавить список ссылок на переобход у вас не получится, их следует добавлять по одной. Вам необходимо кликнуть на кнопку «Проверка URL» и добавить в строку Url-адрес. Это означает, что ее будут индексировать.

Внимание: с 2024 года Google ввёл ограничения на инструмент URL Inspection — количество запросов на индексирование лимитировано. Массовое использование может быть заблокировано.
IndexNow
Это открытый протокол, разработанный Microsoft и Yandex в 2021 году, для мгновенного уведомления поисковых систем о новых или обновленных страницах. Поддерживается Яндексом, Bing, Cloudflare, Naver.
Как это работает: вместо ожидания следующего обхода робота, сайт сам отправляет уведомление в поисковую систему. Индексация может произойти за минуты, а не дни.
Важно: Google официально не поддерживает IndexNow, но для российского SEO с приоритетом на Яндекс — это критически важный инструмент.
- WordPress — через плагин Yoast SEO, Rank Math, All in One SEO (встроенная поддержка).
- Bitrix — через официальный модуль от Яндекса.
- Опубликовать ключ на своём сайте (текстовый файл в корне).
- Отправлять уведомления через API при публикации/обновлении контента.
- Настроить через Cloudflare (если ваш сайт использует Cloudflare как прокси).
Официальный сайт: indexnow.org
Внутренняя перелинковка
Правильно построенная внутренняя перелинковка помогает роботам быстрее находить новые страницы. Ссылки с популярных страниц сайта передают часть авторитета новым материалам, что ускоряет их индексацию.
Внешние ссылки и упоминания
Ссылки с авторитетных сайтов ускоряют индексацию — робот идёт по ссылке и обнаруживает вашу страницу. Также помогают упоминания в соцсетях и на популярных сервисах (Дзен, Пульс, VC.ru).
Как управлять индексацией в поисковиках
У владельца сайта есть несколько инструментов, чтобы указать поисковым системам, какие страницы нужно индексировать, а какие — игнорировать. Разберем каждый из них по порядку.
Файл robots.txt
Его необходимо создать для контроля над индексированием. В нем мы сможем задать правила для поисковых систем, какие странички нужно обходить, а какие – игнорировать. Если на веб-сайте нет такого файла, тогда краулеры будут сканировать весь контент.
В robots.txt можно прописать запрет не только на индексацию мусорных и малополезных разделов, но и указать директиву для закрытия всего ресурса:
User-agent: *
Disallow: /
Если вы не хотите, чтобы боты обходили фильтры, их следует закрыть с помощью правила, например:
User-agent: *
Disallow: /filter*
- данные пользователей;
- корзину;
- поиск;
- фильтрацию в интернет-магазинах;
- версии для печати;
- дубли;
- малополезные странички
- страницы личного кабинета.
- тестовые и служебные разделы..
Однако бывают случаи, когда для одной поисковой системы необходимо закрыть страницы, а для другой — оставить открытыми.
Например, если ваш сайт активно продвигается в Google по международным рынкам, а в Яндексе — только по российскому, вы можете закрыть от Googlebot страницы с региональными фильтрами для нерелевантных стран, оставив их открытыми для Яндекса:
text
User-agent: Googlebot
Disallow: /region/eu/
Disallow: /region/asia/
User-agent: Yandex
Allow: /
Другой сценарий: закрыть от Яндекса тестовые поддомены или служебные разделы, которые нужны только для внутренней работы, но открыть их для Google (например, для тестирования новых функций):
text
User-agent: Yandex
Disallow: /test/
Disallow: /beta/
Также если нужно, чтобы краулеры проиндексировали, например, странички пагинации, указывается разрешающая директива:
text
Allow: */page/*
Мета-тег noindex
Он помогает закрыть от индексации некоторые странички:

Данную строку необходимо разместить в коде сайта в пределах тегов <head>…</head>. Делать это можно как вручную с помощью технических специалистов, так и с использованием различных плагинов.
Важно: не используйте одновременно Disallow в robots.txt и мета-тег noindex — если страница закрыта в robots.txt, робот не сможет её просканировать и увидеть мета-тег noindex. Правильный подход: для закрытия страницы от индекса — noindex. Для запрета сканирования — Disallow.
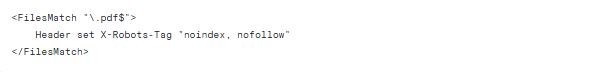
X-Robots-Tag HTTP-заголовок
Ещё один способ закрыть страницу от индексации. Работает так же, как мета-тег noindex, но подходит для файлов, где нельзя прописать мета-теги: PDF, картинки, видео.
Пример настройки в .htaccess:
Канонические URL (rel=»canonical»)
Если на сайте есть похожие или дублирующие страницы (например, товары в разных категориях, страницы с UTM-метками), укажите каноническую версию через тег:

Это подскажет поисковикам, какую версию считать основной и показывать в выдаче. Важно для избежания проблем с дублями.
Как проверить, присутствует ли площадка в поиске
- Google Search Console.
- Яндекс.Вебмастер.
- Оператор site: в поисковике.
- SEO-плагины и расширения.
- Анализ логов сервера.
Разберем каждый метод подробнее.
Google Search Console
В данном сервисе можно посмотреть, проиндексирован ли отдельный url. Для этого вам необходимо найти инструмент «Проверка URL» и добавить адрес страницы в специальную строку:

Если раздел в индексе, отобразится такая информация:

Если же по какой-либо причине боты его не просканировали, вы увидите следующие сведения:

Яндекс.Вебмастер
- Заходим в Яндекс.Вебмастер.
- Раздел «Индексирование» → «Страницы в поиске».
- Смотрим общую статистику индексации.
- Для проверки конкретной страницы используйте инструмент «Проверить статус URL».
Как проверить индексированный контент по поиску
В поисковую строку необходимо ввести url странички, которую хотите проанализировать, но перед адресом следует указать оператор:
site:ссылка

Если страница присутствует в выдаче, значит, она в индексе.
Важно: результаты оператора site: могут быть неточными. Google показывает приблизительное количество проиндексированных страниц. Для точных данных используйте Search Console.
SEO-инструменты
Для проверки сканирования следует скачать для браузера специальное расширение. Наиболее удобное – SEO META in 1 CLICK.
- Title (заголовок страницы) — длину, наличие ключевых слов, корректность.
- Meta Description — заполненность и длину.
- Meta Robots — параметры индексации (index/noindex, follow/nofollow).
- Canonical URL — наличие канонической ссылки.
- Заголовки H1–H6 — структуру, вложенность, дубли и ошибки.
- Изображения — наличие и корректность alt-тегов.
- Ссылки — внутренние и внешние, типы (dofollow/nofollow).
- Open Graph — как страница будет отображаться в соцсетях (og:title, og:description, og:image).
- Технические параметры — язык (lang), кодировку (charset), viewport, favicon.
- Structured Data — наличие микроразметки.
- Доступ к robots.txt и sitemap.xml.
- Длину мета-тегов в пикселях (для оценки отображения в выдаче).
Чтобы проверить SEO-параметры страницы, достаточно открыть плагин — он покажет мета-теги, заголовки, ссылки и технические настройки текущей страницы.
 Читайте также
SEO-тренды на 2023 год: актуальные методы продвижения
Анализ логов сервера
Для крупных сайтов и SEO-специалистов важен мониторинг данных о действиях поисковых роботов на сервере — это позволяет точно понять, какие страницы и когда обходили роботы, где возникают ошибки, как распределяется краулинговый бюджет. Для работы можно использовать инструмент Screaming Frog Log File Analyser.
Сайт не индексируется: что это означает
Первое, что необходимо сделать в такой ситуации – проанализировать robots.txt на наличие в нем запрещающей директивы: Disallow: / . Если она есть, ее необходимо убрать, и ресурс попадет в индекс. Однако это самая безобидная причина, встречаются гораздо серьезнее. Разберем их подробнее.
Технические
- Неверные коды ответа сервера. Странички могут быть проиндексированы в том случае, если они будут отражать 200 ОК. Если код ответа у всех полезных разделов иной – это техническая ошибка, которую следуют решать через техподдержку сайта.
- Мета-тег noindex. Если в кодировке страницы присутствует строка <meta name=»robots» content=»noindex» /> , это означает, что она закрыта от индекса. Открыть ее можно, убрав данный тег.
- X-Robots-Tag в HTTP-заголовках. Проверьте заголовки страницы через инструменты типа PageSpeed — иногда noindex прописан не в HTML, а в заголовках сервера. Для проверки отдельных страниц также подходит Яндекс.Вебмастер.
- Очень медленная загрузка. Проверить скорость загрузки сайта также можно через сервис PageSpeed. Если ресурс находится в красной зоне, его необходимо оптимизировать. Особое внимание стоит уделить показателям Core Web Vitals: LCP < 2,5 сек, INP < 200 мс, CLS < 0,1.
- Ошибки в canonical. Если страница ссылается на другой адрес как на основной, поисковая система может не добавить её в индекс..
- Некорректные редиректы — длинные цепочки 301/302, циклические перенаправления.
Контентные причины
- Малоценные и малополезные странички. Если в каком либо разделе будет очень мало контента, Яндекс исключит его из индекса. Если пользователи на него не переходят, следовательно, он бесполезный и держать его в выдаче нет смысла. Поэтому к наполнению площадки следует относиться с особым вниманием.
- Неуникальный контент. Это размещение информации с низкой уникальностью, из-за этого могут возникнуть проблемы в индексировании. Чтобы их разрешить, достаточно переписать текстовые блоки и удалить старые.
- Дублирование. Поисковые системы негативно относятся к дублям, поэтому при обнаружении дублирующей информации они стараются его убрать из индекса.
- Слабый AI-контент. С 2024 года Google (Helpful Content Update) и Яндекс (алгоритм «Проксима») активно фильтруют низкокачественный сгенерированный ИИ контент без экспертной ценности.
Санкции и алгоритмические ограничения
- Наложение фильтра. Сайт может выпасть из выдачи из-за различных санкций. Например, «Фильтр для взрослых». Если вы столкнулись с такой проблемой, но на страницах нет запрещенного контента, тогда смело пишите в техническую поддержку Яндекса или Google и выясните причину, возможно, произошел сбой на их стороне.
- Наличие вирусов на площадке. Нередко она подвергается взлому, где хакеры могут разместить вредоносный код или совсем сломать ресурс. Проверить можно через Google Search Console (раздел «Безопасность и меры принятые вручную») или Яндекс.Вебмастер.
- Не продлили домен. Чтобы избежать такую проблему, необходимо следить за своевременным продлением доменного имени, если не уложиться в сроки, странички пропадут из индекса.
Специалисты студии SEMANTICA перед началом выполнения работ по продвижению всегда проводят технический аудит сайта, чтобы на начальном этапе выявить все ошибки, связанные с индексацией. Такие задачи выполняются на основе специальных регламентов, которые ежемесячно дорабатываются и актуализируются самими же сотрудниками. Внесение таких изменений позволяет сохранять актуальность критериев качеств, что впоследствии приносит нашим клиентам хорошие результаты по трафику.
Индексация AI-контента
С 2023–2024 гг. поисковые системы активно совершенствуют алгоритмы обнаружения и оценки контента, созданного с помощью нейросетей.
- Google Helpful Content Update — приоритет контенту, созданному для людей, а не для поисковиков. Массовый AI-контент без экспертизы попадает под фильтр.
- Яндекс «Проксима» — алгоритм оценки экспертности контента, учитывает автора, глубину раскрытия темы, наличие уникальных данных.
- Google E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness) — критерии оценки авторитетности.
- Не публиковать «сырой» текст от ChatGPT / Claude без редактуры.
- Добавлять экспертизу: цитаты специалистов, кейсы, статистику, ссылки на источники.
- Указывать автора статьи с реальной квалификацией.
- Обновлять контент — добавлять актуальные данные, скриншоты, примеры.
- Использовать AI как помощника, а не как замену эксперта.
Коды ответа сервера и индексация
Разберём, как разные HTTP-статусы влияют на процесс.
| Код | Что означает | Влияние на индексацию | Что делать |
| 200 OK | Страница успешно загружена | Индексируется нормально | Ничего |
| 301 Moved Permanently | Постоянное перенаправление | Вес переносится на новую страницу | Проверить корректность цели |
| 302 Found | Временное перенаправление | Вес может не передаваться полностью | Заменить на 301, если перенаправление постоянное |
| 404 Not Found | Страница не найдена | Не индексируется | Настроить 301 на релевантную страницу |
| 410 Gone | Страница удалена навсегда | Не индексируется, быстрее исключается из поиска | Использовать для удаленного контента |
| 500 Internal Server Error | Ошибка сервера | Индексация приостанавливается | Срочно исправить серверную ошибку |
| 503 Service Unavailable | Сервис временно недоступен | Робот вернется позже | Использовать при плановых работах |
Список действий, если страница не индексируется
- Проверить robots.txt на наличие Disallow для этой страницы.
- Определить наличие мета-тега noindex в <head> страницы.
- Выявить X-Robots-Tag в HTTP-заголовках.
- Убедиться, что страница возвращает код 200 OK.
- Проанализировать настройки canonical — указывает ли на эту же страницу.
- Проверить, не закрыта ли страница паролем или требует ли авторизации.
- Убедиться, что страница есть в sitemap.xml.
- Проверить внутренние ссылки — есть ли пути к странице от главной.
- Оценить качество контента — уникальный, полезный, объёмный.
- Проверить рендеринг JavaScript через «Проверка URL» в GSC.
- Оценить Core Web Vitals — скорость и удобство страницы.
- Проверить, нет ли ручных санкций в Google Search Console / Яндекс.Вебмастере.
- Отправить страницу на переобход через инструменты вебмастера.
- Использовать IndexNow для ускорения индексации в Яндексе.
- Дождаться 2–4 недели для новых страниц молодых сайтов.
Заключение
В этой статье мы рассказали про индексирование страниц, описали, что это такое, как поисковые системы индексирую веб-проекты и что значит ускорение и управление индексом сайта. Сканирование ресурса – это важный процесс, который нужно отслеживать, если вы хотите продвигать площадку в ПС и получить органический трафик.
Вопросы – ответы
Для нового ресурса — от 1 до 4 недель в Google и от 2 до 4 недель в Яндексе. Ускорить процесс можно через отправку sitemap в вебмастерах, IndexNow (для Яндекса), внешние ссылки на веб-сайт.
Самые быстрые способы:
- отправить URL через «Проверка URL» в Google Search Console;
- добавить в «Переобход страниц» в Яндекс.Вебмастере;
- использовать IndexNow (индексация в Яндексе за минуты);
- поставить ссылку с уже проиндексированной страницы сайта.
Основные причины: закрыт в robots.txt (Disallow: /), мета-тег noindex, некорректные коды ответа сервера, дублирующийся или неуникальный контент, наложение фильтров. Пройдите чек-лист выше для диагностики.
Быстрый способ: добавить мета-теги подождать переобхода. Для срочного удаления — использовать инструмент «Удаление URL» в Google Search Console (временное удаление на 6 месяцев). Также можно вернуть код 410 (Gone).
Это разные инструменты. Robots.txt указывает, что можно/нельзя обходить. Sitemap.xml помогает роботу быстрее найти все важные страницы, указать приоритеты и даты обновления. Особенно важно для больших сайтов и сайтов со сложной структурой.
Это количество страниц, которые робот готов обойти на сайте за определенное время. Для сайтов до 10 000 страниц редко становится проблемой. Для крупных проектов важно оптимизировать: закрывать мусорные страницы, ускорять сервер, правильно настраивать sitemap.


