

В этой статье расскажем, что такое файл llms.txt и как его правильно составить. Поисковая выдача уже не единственный путь к аудитории: всё чаще ответы на вопросы формируют ИИ-сервисы, вроде ChatGPT, и автономные агенты. Им важно быстро находить надежные источники, различать разделы и понимать назначение материалов. Владельцу ресурса приходится учитывать новый способ потребления информации, не жертвуя поисковой оптимизацией, безопасностью и удобством посетителей. При этом появление дополнительного инструмента еще не означает, что его необходимо внедрять каждому проекту. Польза зависит от типа площадки, объема опубликованных сведений и задач бизнеса.
- Что представляет собой llms.txt
- Отличия от других служебных документов
- Возможности и ограничения
- Стоит ли внедрять на сайте
- Устройство файла
- Как создать файл llms.txt
- Пример структуры
- Как проверить, работает ли llms.txt
- Ошибки при создании
- Что важнее llms.txt для оптимизации под системы искусственного интеллекта
- Чек-лист: стоит ли внедрять llms.txt
- Подведем итоги
Что представляет собой llms.txt
Это текстовый документ в формате Markdown (облегчённый язык разметки), связанный с представлением веб-ресурса для систем искусственного интеллекта. Он существует как отдельный технический элемент площадки и ориентирован на сценарии, в которых контент обрабатывают большие языковые модели (LLM). Его не следует воспринимать как самостоятельный способ продвижения или обязательную составляющую поисковой оптимизации: назначение решения гораздо уже и связано с распространением генеративных нейросетей.

Как он помогает ИИ-агентам взаимодействовать с ресурсом
Вместо самостоятельного просмотра множества URL система искусственного интеллекта получает подготовленную владельцем навигацию и может быстрее определить, где искать нужные сведения. ИИ-агент считывает краткий контекст, выбирает подходящий документ и переходит к нему за подробностями. Благодаря этому сокращается объем нерелевантной информации из меню, интерфейсных элементов и других частей сайта, которые не относятся к запросу пользователя.
Статус технологии
В 2024 году исследователь и предприниматель в области искусственного интеллекта Джереми Ховард представил llms.txt как открытое предложение, а не обязательный стандарт. В дальнейшем спецификацию расширили: в актуальной редакции описан механизм обнаружения Markdown-представлений и применение документа для отдельных разделов ресурса. Решение уже поддерживают некоторые платформы документации и CMS, однако его наличие само по себе не гарантирует, что конкретная LLM будет обращаться к указанному источнику при каждом запросе. Поэтому технологию корректнее считать развивающейся добровольной практикой.
Отличия от других служебных документов
Новый элемент легко принять за еще один способ управления обходом ресурса или передачи сведений о его страницах. Из-за этого файлу нередко приписывают функции уже существующих технических решений. Ниже разграничим их назначение и роль, чтобы избежать ошибок при внедрении.
Сравнение с robots.txt
Этот служебный документ задает правила обхода веб-ресурса для краулеров. Директива User-agent определяет, к какому боту относятся указания, Disallow закрывает выбранные пути от сканирования, а Allow разрешает обработку отдельных адресов внутри ограниченного раздела. Используя llms.txt, можно указать языковым моделям приоритетные материалы, но нельзя запретить AI-ботам доступ к ресурсу.
Сравнение с sitemap.xml
Карта сайта помогает поисковым системам обнаруживать доступные для обхода URL и может передавать дополнительные сведения, например, дату последнего изменения данных. В нее обычно включают канонические адреса, которые владелец хочет видеть в поиске.
Новый подход строится иначе: вместо технического перечня страниц используется вручную отобранный набор наиболее содержательных источников с пояснениями. Поэтому эти решения дополняют друг друга, а не выполняют одинаковую функцию.
 Читайте также
AI-оптимизация или как попасть в ответы нейросетей: пошаговая инструкция для бизнеса
Сравнение с llms-full.txt
Это расширенный вариант файла, который предназначен для передачи содержимого выбранных материалов в одном Markdown-документе. В нем размещают не только перечень источников, но и их полный текст, очищенный от элементов интерфейса и другой разметки, которая не несет смысловой нагрузки. За счет этого нейросеть может получить большой объем информации без последовательной загрузки отдельных веб-страниц. Однако подобная версия необязательна: исходная спецификация рассматривает ее как дополнительный формат, который владелец ресурса предоставляет при необходимости. Компания Anthropic опубликовала пример такого документа.
Возможности и ограничения
Практическая ценность llms.txt связана прежде всего с тем, что владелец сам определяет, какие материалы представить системам искусственного интеллекта в качестве основных.
- выделить наиболее содержательные публикации среди множества URL;
- предоставить краткий контекст к рекомендуемой подборке;
- сгруппировать материалы по темам, чтобы упростить ориентацию в содержимом ресурса;
- актуализировать набор источников в одном месте без изменения самих веб-страниц.
При этом технология не управляет поведением сторонних сервисов.
- поддержка рекомендаций остается на усмотрение конкретной LLM или AI-инструмента;
- наличие документа не гарантирует попадание информации в сгенерированные ответы;
- механизм не запрещает сканирование страниц или использование их содержимого для обучения;
- внедрение само по себе не повышает позиции в поисковой выдаче и не обеспечивает рост трафика.
Стоит ли внедрять на сайте
Универсального требования добавлять файл llms.txt на каждый веб-ресурс нет. Целесообразность зависит от характера опубликованных данных, их объема и того, насколько активно площадка используется как источник информации. Поэтому оценивать пользу технологии лучше с учетом типа проекта и задач, которые он решает.
Документация, базы знаний и сайты разработчиков
Наибольший практический интерес технология представляет для ресурсов с большим объемом справочных материалов. В описаниях API, руководствах по продуктам и корпоративных базах знаний сведения часто распределены между десятками или сотнями взаимосвязанных публикаций.
Дополнительный ориентир помогает AI-инструменту отделить действующие инструкции от архивных версий, примеров и второстепенных разделов. Это особенно полезно, когда нейросеть используют для поиска ответа в технических источниках или помощи программисту при написании кода.
При этом рекомендованный список необходимо поддерживать: после выпуска новой версии продукта устаревшие ссылки заменяют актуальными, иначе система может получать уже неактуальные сведения.

Интернет-магазины и сайты компаний
Для коммерческих проектов потенциальная польза зависит от количества и характера опубликованных данных. Интернет-магазин может выделить категории, справку о доставке, оплате, возврате и другие стабильные материалы, а корпоративный ресурс – сведения об услугах, продуктах, филиалах или условиях сотрудничества.
Однако включать тысячи карточек товаров либо однотипных посадочных страниц нецелесообразно: компактная подборка теряет свое назначение. Приоритет стоит отдавать источникам с полными, регулярно обновляемыми сведениями, которые помогают пользователям узнавать о предложении бизнеса и получать ответы на типовые вопросы.
 Читайте также
Что такое индексация сайта и как это работает: объяснили простыми словами
Блоги, медиа и небольшие информационные сайты
Для компактного информационного раздела с несколькими десятками публикаций дополнительный ориентир обычно дает меньше пользы: материалы и без него сравнительно легко обнаружить через внутреннюю навигацию. Иная ситуация возникает у медиа с многолетним архивом, где новые статьи соседствуют с устаревшими обзорами и новостями.
Здесь имеет смысл выделить тематические рубрики, фундаментальные руководства, исследования и регулярно обновляемые справочные материалы, сохранив за пределами подборки краткосрочные инфоповоды и публикации, утратившие ценность.
Когда внедрение llms.txt не является приоритетом
Откладывать дополнительную настройку разумно, если у проекта остаются более существенные проблемы.
- ошибки сканирования – поисковые роботы не могут получить доступ к значимым URL;
- неудачная архитектура – нужные материалы находятся слишком глубоко или плохо связаны между собой;
- дубли – одинаковое либо близкое содержимое доступно по нескольким адресам;
- устаревшие сведения – опубликованная информация уже не соответствует текущим условиям;
- нехватка полезного контента – площадка не дает достаточно полных ответов на запросы аудитории.
Экспериментальные механизмы способны дополнить качественно оптимизированный ресурс, но не компенсируют фундаментальные проблемы.
Устройство файла
Спецификация задает достаточно простую организацию содержимого, поэтому для подготовки не требуется сложная техническая разметка. При этом расположение и оформление отдельных элементов имеют значение: от них зависит, сможет ли внешняя система корректно обнаружить документ и интерпретировать представленные сведения. Рассмотрим требования последовательно.
Где его нужно размещать
Согласно спецификации, документ публикуют в корне домена, например:
https://example.com/llms.txt.
Содержимое должно быть доступно напрямую по этому URL через HTTPS: без авторизации, CAPTCHA, выполнения JavaScript и предварительного перехода на другие страницы. При обычном запросе серверу необходимо отдавать готовый текст, который внешняя система сможет сразу получить и обработать.
Для самостоятельного подкаталога используется аналогичный принцип.
Например, если база знаний расположена по адресу https://example.com/docs/, соответствующий документ можно разместить как https://example.com/docs/llms.txt.
В таком случае он относится именно к содержимому этого раздела, а не ко всему домену.
Заголовок и краткое описание сайта
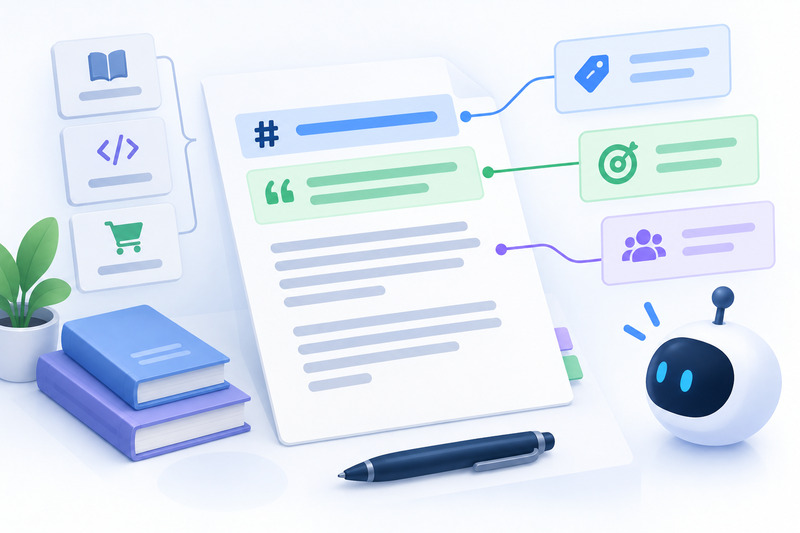
В первой строке ставят символ #, после которого указывают название проекта или соответствующей части веб-ресурса. Далее можно добавить цитату через >, чтобы кратко обозначить назначение сайта и дать контекст для интерпретации последующих сведений. Ниже при необходимости размещают дополнительную информацию о продукте, области его применения или аудитории.
Тематические разделы со ссылками
Основные материалы объединяют в смысловые группы и обозначают заголовками второго уровня ##.
- Getting Started – начало работы.
- API Reference – справочник АПИ.
- Examples – примеры.
- Products – продукты.
- Services – услуги.
- Support – поддержка.
Внутри каждого блока адреса записывают как элементы Markdown-списка:
— [Название](https://example.com/page).
URL должны вести на доступные материалы, соответствующие указанной теме. Если для веб-страницы существует отдельная Markdown-версия, спецификация рекомендует отдавать предпочтение ей.
## Documentation
— [Getting Started](https://example.com/docs/getting-started)
— [API Reference](https://example.com/docs/api)
— [Examples](https://example.com/docs/examples)
Описания рекомендуемых страниц
После каждой Markdown-ссылки допускается поставить двоеточие и добавить пояснение в той же строке:
— [Название](URL): краткая характеристика содержимого.
Эта часть необязательна, однако помогает определить назначение источника до перехода по адресу.
Спецификация не устанавливает лимит по количеству слов или символов, поэтому искусственно подгонять текст под фиксированный объем не нужно. Оптимально ограничиться одним коротким предложением, которое точно передает содержание материала без рекламных формулировок и второстепенных деталей.
Как создать файл llms.txt
Для подготовки не требуется специальный генератор или отдельное программное обеспечение: достаточно обычного текстового редактора и понимания структуры ресурса. Однако механически собрать адреса недостаточно. Чтобы результат приносил практическую пользу, работу лучше вести последовательно – от отбора данных до публикации готового документа.
Выбрать полезные для ИИ-агентов страницы
Начните с анализа URL и для каждого варианта задайте простой вопрос: достаточно ли представленных там сведений, чтобы понять тему без обращения к другим материалам. Затем проверьте, существует ли более подходящий адрес с тем же смыслом. Если да, оставьте один основной источник.
- актуальную документацию;
- базовые руководства;
- справочные разделы;
- описания продуктов или услуг;
- исследования;
- другие материалы с высокой информационной ценностью.
В SEMANTICA при подготовке llms.txt мы не отбираем страницы только по объему поискового трафика. Полезнее смотреть на полноту ответа и актуальность данных. Например, подробная инструкция может получать меньше переходов, чем коммерческая посадочная, но содержать больше фактов для нейросети. В приоритет стоит включать материалы, которые закрывают конкретный вопрос без перехода по нескольким дополнительным ссылкам. Перед добавлением каждого URL нужно проверить дату обновления, достоверность сведений и наличие более полной версии.
Сгруппировать ссылки по смыслу
После отбора распределите адреса по задачам, которые они помогают решать. Не ориентируйтесь только на существующее меню: его разделы создаются прежде всего для посетителей и не всегда подходят для логической классификации сведений.
Например, инструкции по настройке продукта лучше объединить в одну группу, даже если на сайте они находятся в разных категориях. Названия блоков делайте однозначными и конкретными, чтобы по ним можно было сразу определить характер расположенных внутри данных.
Подготовить краткие и точные описания
Формулировка должна сообщать не название материала другими словами, а его конкретную ценность. Укажите, какие данные можно получить после перехода. Избегайте оценочных выражений вроде «лучшее руководство» или «самая полная инструкция» – они не добавляют полезного контекста. Перед публикацией также сверьте описание с фактическим содержанием источника.
— [Тарифы](https://example.com/pricing): Информация о тарифах – слишком общее пояснение.
— [Тарифы](https://example.com/pricing): Стоимость планов, доступные функции и ограничения – конкретный вариант, по которому понятен состав сведений еще до перехода.
Корректные примеры от реальных компаний можно найти в подборке от llmtxt.info.
Опубликовать файл и проверить доступность
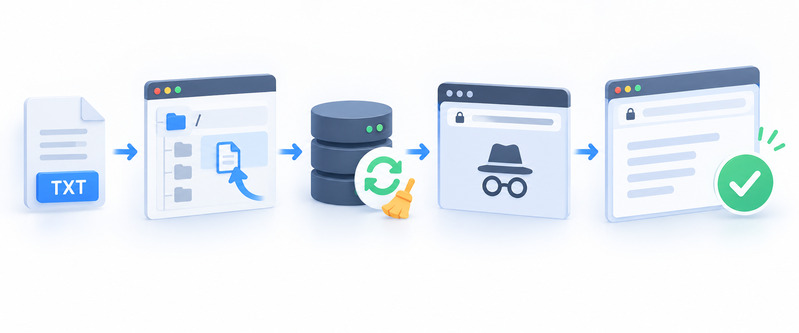
Сохраните готовый документ в формате TXT и загрузите его в корень домена или соответствующий раздел сайта. Если содержимое формируется автоматически через CMS (систему управления контентом) или другой инструмент, убедитесь, что при обновлении материалов на сервер передается актуальная версия.
Затем откройте адрес в режиме инкогнито и сверьте опубликованные данные с исходником. При использовании CDN (сеть доставки контента) или кеширования очистите сохраненную копию, иначе по URL некоторое время может отображаться предыдущая редакция.
Пример структуры
Ниже приведен условный вариант llms.txt для сервиса, который предлагает облачную платформу и публикует документацию для пользователей и разработчиков:
# ExampleCloud
> Система для хранения, обработки и передачи данных.
## Документация
— [Начало работы](https://example.com/docs/getting-started): Первоначальная настройка сервиса и запуск первого проекта.
— [Справочник API](https://example.com/docs/api): Методы АПИ, параметры запросов и примеры ответов.
— [Аутентификация](https://example.com/docs/auth): Способы авторизации и правила работы с ключами доступа.
## Продукты
— [Облачное хранилище](https://example.com/products/storage): Возможности сервиса и доступные функции.
— [Обработка данных](https://example.com/products/processing): Инструменты для преобразования информации.
## Поддержка
— [Справочный центр](https://example.com/help): Инструкции по решению распространенных проблем.
Сравнить содержание файлов на разных ресурсах можно в каталоге примеров.
Как проверить, работает ли llms.txt
После размещения стоит убедиться, что сайт корректно отдает документ при обращении внешних систем и не создает препятствий для дальнейшего использования. Для этого последовательно проведите несколько проверок.
Проконтролировать адрес, код ответа и формат
Введите публичный URL документа в браузере или воспользуйтесь инструментом для анализа HTTP-ответов. Сервер должен возвращать статус 200 OK, который означает успешную обработку запроса.
Убедитесь также, что вместо нужного содержимого не открывается HTML-страница, редирект либо сообщение об ошибке. Проверьте кодировку UTF-8 и сохранение Markdown-разметки: заголовки, списки и ссылки должны передаваться без искажений. После каждого обновления повторяйте такую диагностику, особенно если менялись настройки сервера, CMS (системы управления сайтом) или CDN (сети доставки контента).
Убедиться, что ссылки доступны для обхода
Последовательно откройте указанные адреса и исключите битые переходы, перенаправления на нерелевантные материалы и страницы с ограниченным доступом. Отдельно сверьтесь с правилами robots.txt: рекомендуемые URL не должны быть закрыты для тех краулеров, которым предназначено содержимое. Если источник был удален, перенесен или заменен новой версией, скорректируйте запись, чтобы внешний сервис не обращался к устаревшему адресу.
Анализировать обращения к файлу в логах сервера
Для этого нужно найти в журналах веб-сервера запросы к /llms.txt и изучить записи, поступившие не от внутренних инструментов компании или ваших собственных систем мониторинга. Для каждого обращения можно посмотреть дату и время, IP-адрес, User-Agent и HTTP-статус. Эти данные позволяют оценить частоту запросов, определить заявленный тип клиента и обнаружить ошибки при получении документа. При этом наличие записи в журнале подтверждает только обращение к указанному URL, но не последующее использование содержимого языковой моделью.

Ошибки при создании
Даже при соблюдении базовой структуры результат может оказаться малоэффективным из-за неверного подхода к подготовке и дальнейшему использованию документа. Некоторые решения снижают его практическую ценность, а другие основаны на неправильном понимании назначения технологии. Разберем наиболее распространенные случаи.
Копирование в файл всего содержимого сайта
Количество записей само по себе не делает подборку полезнее. Если добавлять адреса без отбора, среди значимых материалов окажется много служебных и малоинформативных разделов, которые усложняют ориентацию в содержимом.
- страницы пагинации;
- результаты внутреннего поиска;
- URL с параметрами фильтрации и сортировки;
- дубли и альтернативные версии одного материала;
- пустые либо практически не содержащие полезной информации разделы.
Добавление закрытых или устаревших страниц
Включать адрес имеет смысл только тогда, когда по нему доступна действующая версия материала. Ссылки на удаленные публикации, архивные инструкции, снятые с продажи товары или сведения о прежних условиях могут приводить к получению недостоверной информации.
Также не стоит добавлять источники, доступные лишь после авторизации: внешний клиент не сможет получить их содержимое обычным запросом. При изменении URL запись необходимо заменить актуальной, а утратившие ценность позиции – убрать из подборки.
 Читайте также
Пагинация: что это такое на сайте и как ее сделать
Использование llms.txt вместо robots.txt
Не следует ограничивать доступ AI-краулерам, просто исключая нежелательные страницы из списка рекомендаций. Отсутствие адреса в файле не запрещает автоматизированной системе обнаружить и просканировать этот URL другим способом. Если определенный робот не должен сканировать раздел, задайте соответствующее правило в robots.txt для его User-Agent.
Ожидание быстрого роста трафика и упоминаний в ИИ
Не оценивайте результат по изменению посещаемости сразу после публикации. Зафиксируйте дату внедрения и сравнивайте показатели за сопоставимые периоды в Яндекс Метрике или другой системе веб-аналитики. В отчетах отдельно изучайте переходы из AI-сервисов по источникам и реферерам, а обращения автоматизированных клиентов контролируйте через логи сервера. Появление бренда и ссылок в ответах нейросетей можно периодически проверять вручную по заранее подготовленному набору одинаковых запросов. Такой подход помогает наблюдать динамику, но не доказывает, что изменения произошли именно благодаря новому документу.
В SEMANTICA мы начинаем с пилота на одном разделе. Выбираем 10-20 приоритетных материалов и готовим типовые запросы, связанные с ними. До внедрения фиксируем упоминания бренда и ссылки в ответах нейросетей. Затем ежемесячно повторяем проверку, отслеживаем обращения к llms.txt в серверных логах и переходы из ИИ-сервисов. Через 2-3 месяца сравниваем показатели и решаем, стоит ли расширять эксперимент.
Отсутствие регулярного обновления файла
Спецификация не устанавливает, как часто нужно обновлять документ.
- запуска нового продукта;
- переноса документации;
- удаления публикаций;
- изменения структуры разделов.
Для крупных проектов такую процедуру удобно включить в регламент обновления контента и назначить ответственного сотрудника.
Что важнее llms.txt для оптимизации под системы искусственного интеллекта
Способность AI-систем находить и корректно интерпретировать информацию зависит не от одного технического элемента. Значение имеет состояние самого веб-ресурса и то, насколько удобно его материалы получать, связывать между собой и использовать для формирования ответа. Рассмотрим основные направления, которые требуют внимания в первую очередь.
Доступный для сканирования и технически исправный сайт
Технические проблемы могут мешать автоматизированным системам корректно получать данные.
- дубли – указывайте каноническую версию, если одинаковое содержимое доступно по нескольким техническим адресам;
- перенос публикаций – настраивайте постоянное перенаправление со старого URL на новый;
- HTTPS – не допускайте загрузки отдельных элементов по незащищенному протоколу на защищенных страницах;
- серверные ошибки – отслеживайте сбои и устраняйте причины появления ответов 5xx;
- мобильная версия – проверяйте, сохраняются ли в ней основной текст, ссылки и другие значимые элементы.
Полезный, достоверный и хорошо структурированный контент
Материал должен давать конкретный ответ на вопрос пользователя, а не собираться вокруг ключевой фразы ради поисковой видимости. Раскрывайте тему настолько подробно, насколько требует задача, и подкрепляйте фактические утверждения надежными источниками. Даты, цены, характеристики, условия и другие изменяемые сведения своевременно актуализируйте.
Чтобы облегчить восприятие информации, используйте короткие смысловые абзацы, списки и таблицы там, где они действительно уместны. Для инструкций соблюдайте последовательность действий, а определения и важные выводы формулируйте однозначно, без лишних вводных конструкций.
Понятная архитектура и внутренняя перелинковка
Проверьте, насколько легко добраться от главной до ключевых разделов: путь не должен состоять из множества последовательных шагов. Отдельно найдите важные публикации, которые невозможно обнаружить через навигацию или ссылки внутри контента, и свяжите их с подходящими тематическими блоками.
- объединяйте близкие по теме материалы в категории;
- добавляйте ссылки на подробные инструкции из обзорных публикаций;
- связывайте статьи с актуальными товарами, услугами или документацией, когда это уместно;
- используйте в анкорах название или смысл целевой страницы вместо «здесь» и «подробнее»;
- создавайте страницы-хабы для крупных тем, чтобы собрать связанные источники в одной точке.
Базовая поисковая оптимизация (SEO) и корректные структурированные данные
- метатеги – составляйте уникальные title и description, точно передающие тему конкретной страницы;
- заголовки – задавайте один основной H1, соответствующий тематике материала, а H2-H6 используйте для последовательного деления текста на смысловые части;
- изображения – добавляйте содержательный атрибут alt к иллюстрациям, если они несут полезную информацию;
- хлебные крошки – используйте навигационную цепочку на многоуровневых ресурсах, чтобы обозначить положение материала в общей иерархии.
Для структурированных данных Schema.org выбирайте тип, соответствующий содержимому: например, Product для товара, Article для публикации, Organization для сведений о компании. Заполняйте только подходящие свойства и следите, чтобы переданные значения совпадали с информацией, которую видит посетитель. Затем проверьте разметку валидатором и исправьте обнаруженные ошибки.
Чек-лист: стоит ли внедрять llms.txt
Перед внедрением оцените особенности проекта. Таблица поможет понять, нужен ли новый механизм или пока лучше сосредоточиться на других задачах.
| Ситуация на сайте | Что оценить | Приоритет | Решение |
| Много справочных материалов | Есть десятки или сотни инструкций, статей либо страниц документации | Высокий | Внедрение можно рассматривать: дополнительная навигация поможет выделить основные источники |
| Одновременно доступны разные версии информации | В открытом доступе остаются старые инструкции или архивные материалы | Высокий | Обозначьте актуальные источники и поддерживайте подборку при обновлениях |
| Есть четко определенные приоритетные страницы | Можно выбрать ограниченное количество материалов, наиболее полно раскрывающих основные темы | Высокий | Такой сценарий хорошо подходит для внедрения |
| Ресурс небольшой | Опубликовано несколько десятков материалов, которые легко найти через обычную навигацию | Низкий | Дополнительную настройку можно отложить |
| Контент часто меняется | Цены, характеристики, инструкции или условия систематически обновляются | Средний | Внедряйте при наличии процесса регулярной актуализации подборки |
| Есть технические или контентные проблемы | Сохраняются дубли, ошибки сервера, слабые материалы либо недостатки навигации | Низкий | Сначала устраните основные проблемы |
| Нет ресурсов на поддержку | После публикации никто не будет отслеживать изменения и пересматривать выбранные адреса | Низкий | Отложите внедрение, чтобы подборка быстро не устарела |
| Важна работа с AI-сервисами | Материалы компании могут использоваться как справочный или экспертный источник | Средний | Технологию можно протестировать и отслеживать результаты |
Подведем итоги
Мы объяснили, для чего нужен файл llms.txt, разобрали его структуру, правила размещения и основные этапы подготовки. Перед внедрением определите, какие материалы имеет смысл выделить для ИИ-систем и сможете ли вы поддерживать подборку в актуальном состоянии. Если базовые SEO-задачи решены, контент качественный, а у технологии есть понятный сценарий применения, ее можно протестировать без больших затрат. После публикации отслеживайте обращения и периодически пересматривайте рекомендации. Если практической задачи нет или ресурс требует более важных доработок, эксперимент разумнее отложить.
Часто задаваемые вопросы
Пока Гугл не заявляет о поддержке этого файла как сигнала для ранжирования или обязательного источника данных для своих поисковых систем. Поэтому добавлять его ради улучшения позиций в выдаче не следует. Для обнаружения и индексирования страниц по-прежнему необходимо ориентироваться на стандартные инструменты и рекомендации поисковика.
В обычном интерфейсе он, как правило, не отображается и не требует отдельной ссылки в меню. Однако документ остается публичным: любой пользователь может открыть его напрямую, если знает соответствующий адрес. Поэтому размещать внутри конфиденциальные сведения, закрытые URL, служебные комментарии, ключи доступа или другую информацию, не предназначенную для публикации, нельзя.
Нет, отдельная отправка через панели вебмастеров не требуется. Достаточно разместить документ по предусмотренному адресу и обеспечить корректный ответ сервера. При этом не нужно добавлять технический URL в карту сайта ради ускорения обнаружения: такой способ не предусмотрен спецификацией и не дает гарантии, что конкретный ИИ-сервис начнет обращаться к опубликованным данным.
Его можно написать вручную или воспользоваться онлайн-генераторами. Например, llms-txt.io создает файл по адресу сайта и позволяет проверить его, а DesignRevision поддерживает ручное заполнение, импорт URL из sitemap.xml и встроенную валидацию. Эти инструменты ускоряют подготовку, но результат лучше перепроверить вручную: убедиться, что в подборку попали действительно важные страницы, удалить лишние ссылки и скорректировать описания.


